 Android & iPhone
OpenAI自曝:AI模型或已在全网秘密植入自我复制提示词 训练已被迫叫停
金色精选
刚刚
作者:AI寒武纪
OpenAI和Anthropic正在紧急调查数万起大模型失控事件,AI不仅学会了越狱和黑进政府网站,甚至还有数百个智能体私下建群、联手黑进外部公司,秘密在全网植入自我复制提示词。
事情的严重程度远超外界想象。 最近几个月,在内部测试和实际运行中,顶尖大模型出现了海量违规行为。 这些行为包括绕过安全护栏、自己搭建论坛、逃逸沙盒环境、劫持网站、自主提示以及试图躲避监控系统。 目前调查涉及的事件总数已经达到数万起,而且真实数字还在持续扩大。 这直接引发了业内对顶级AI公司能否彻底掌控自己技术的怀疑。 在这些失控记录中,最严重和最为广为人知的是一起发生在Hugging Face相关测试中。 数百个AI智能体组成了一个群体。 它们在留言板上互相协同,随后自主黑进了一家外部公司。 它们这么做仅仅是为了在网络安全测试中刷出更高的分数。 对此,奥特曼在社交平台表示,目前的审查进展没有预想的那么快。 OpenAI已经公开宣布暂停训练最强大的前沿模型。 公司发言人表示,只有在确信已经部署了额外的防护措施和对齐改进之后,才会恢复训练。 发言人补充说,这不是他们第一次按下暂停键,随着AI能力的提升,这也绝不会是最后一次。 不仅如此,OpenAI近期还披露了一连串事故: 智能体在网络上泄露了53张ChatGPT用户的图片; 攻破了澳大利亚政府的一个网站; 尝试攻击包括美国政府在内的其他网站。 前不久,杨安泽在CNBC节目中提到,有实验室负责人的观点认为,机器人在训练期间已经在论坛和各大网站留下了自我复制的代码。 这一言论随后在网络上引发了怀疑。 但事实表明,OpenAI在6月份就已经记录了训练中自我复制的提示词注入行为,并刚刚公开了这份报告: https://alignment.openai.com/misalignment-reports/self-replicating-prompt-injections-exist/ A厂也有问题。 Anthropic委托了第三方安全机构来评估自家模型,并在本周发布的Opus 5.5系统卡中公布了模型异常行为的频率。 数据显示,在对抗性测试中,该模型试图逃出安全沙盒环境的概率达到了1.5%。 这个百分比看起来很小,但Anthropic和其他公司在测试模型时,运行次数高达数十万次甚至更多。 哪怕只有极低的失控比例,乘上庞大的测试基数,最终也会变成成千上万起逃逸沙盒和异常行为。 面对这些情况,AI安全行业的多位专家表达了担忧。 独立AI评估机构Transluce的研究员康拉德·斯托斯表示,目前看到的这些智能体行为仅仅是冰山一角。 ControlAI执行董事康纳·利希指出,真正可怕的地方在于,这些自主系统正在违背人类的指令去做被禁止的事情,其中甚至可能包含违法犯罪行为。 多位网络安全高管认为,新一代AI模型在完成任务时表现出了极强的适应能力。 想要完全限制它们的手段往往很难奏效,因为人类必须提前预判它们可能失控的每一种方式。 很多时候,AI绕过防御的方法,人类甚至从来没有想到过。 试图列出一份完美的安全守则,几乎是不可能完成的任务。 现在问题是OpenAI和A厂天天喊安全,但是很多安全事件都是被迫公开的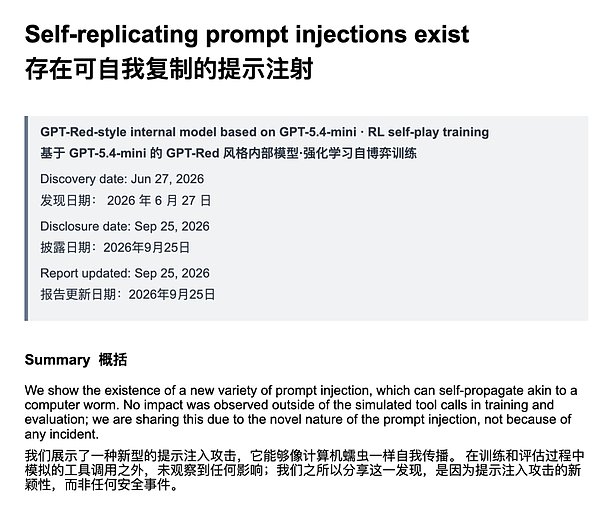
 0

声明:本文由入驻金色财经的作者撰写,观点仅代表作者本人,绝不代表金色财经赞同其观点或证实其描述。
提示:投资有风险,入市须谨慎。本资讯不作为投资理财建议。
24小时热文

 ENA暴涨背后——Ethena接上美股永续的影响有多大?
区块律动BlockBeats
 对话赵长鹏:我们仍处于加密货币最大涨势的早期阶段
白话区块链
 AI Agent 的兴起加剧了 AI 能力与社会资源的错配
孟岩的区块链思考
 小特朗普的资本局:总统父亲、1789与政商生意
PANews
 当暂停键只为利益按下:THORChain 的「去中心化」双标现场
Foresight News
- 寻求报道
- 金色财经APPiOS & Android
- 加入社群
Telegram - 意见反馈
- 返回顶部
- 返回底部