 Android & iPhone
Meta最强旗舰碾压GPT-6和Opus 一夜杀回世界前三

新智元
刚刚
小扎这次,真追上来了!
深夜,Meta一口气发布Muse Wonder和Muse Wonder Full两款大模型。
官方毫不客气地将其定义为,Meta迄今为止最强模型,也是全面迈向「个人超级智能」历史性飞跃。
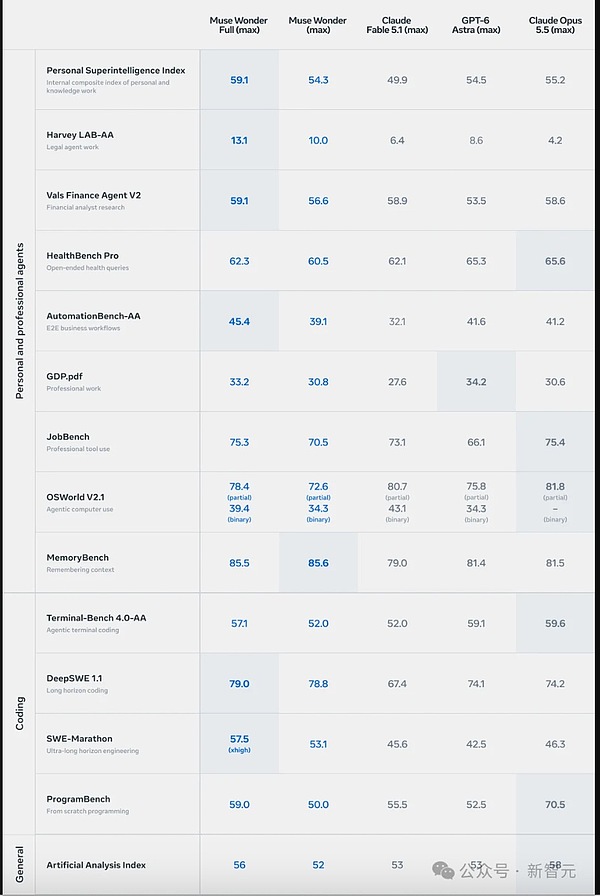
在各项基准测试中,Meta「双弹」终于能和Claude、GPT正面竞争了。
如今最强的Claude Fable 5.1和GPT-6 Astra,几乎被Muse Wonder直接踩在了脚下。
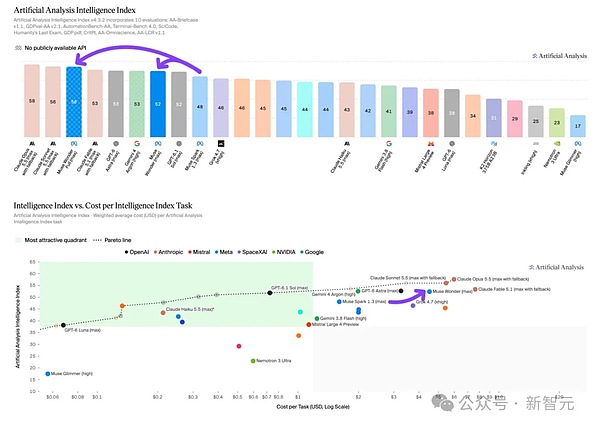
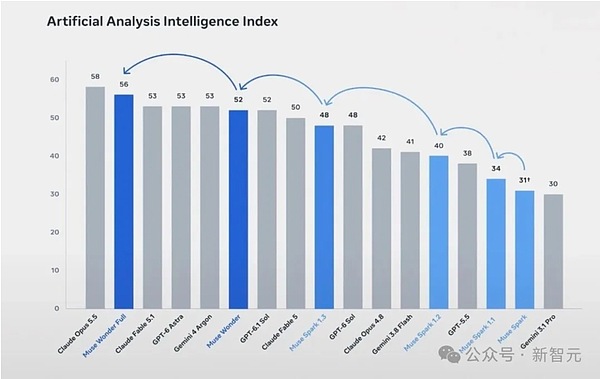
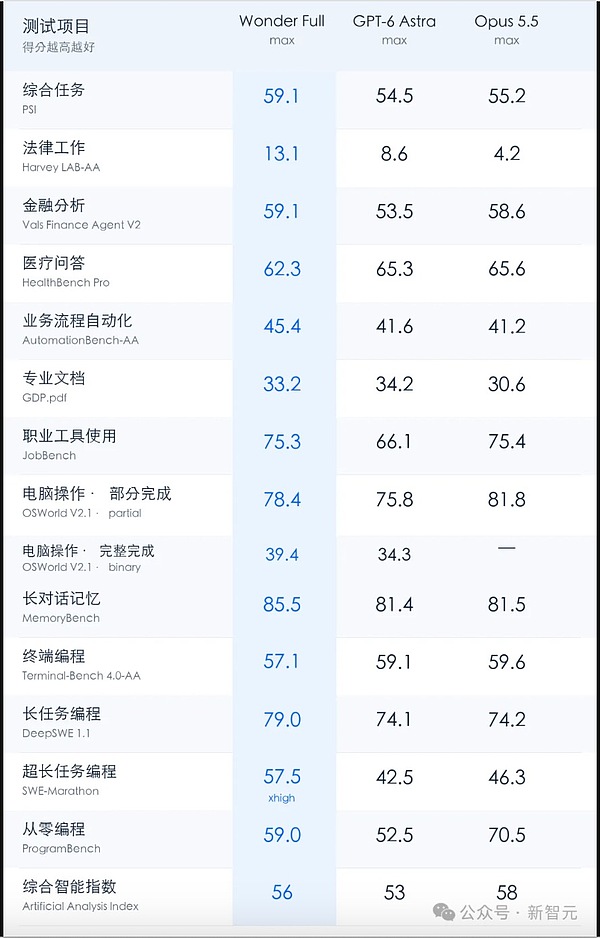
在Artificial Analysis上,Muse Wonder Full斩获56分,稳居全球第一梯队,与Sonnet 5.5并驾齐驱,压制了GPT-6 Astra。
Muse Wonder同样拿下52分,全面反超了上一代Muse Spark 1.3。
到了长任务编程,Meta更是直接反超Opus和Astra。不光最高档的Full赢了,普通版Wonder也赢了!
它手里握着两张最大的王牌,Active Memory(主动记忆)+ Active Focus(主动专注)。
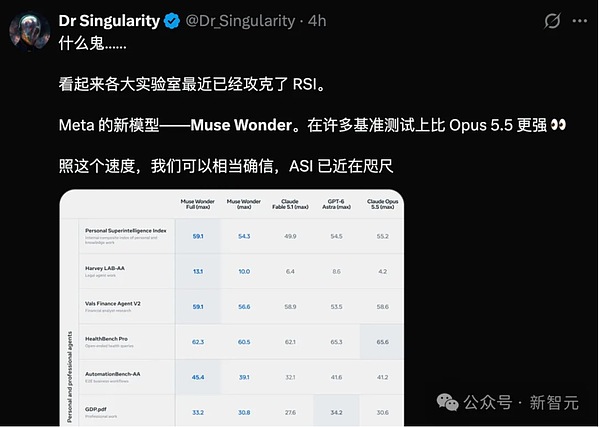
一时间,许多人纷纷惊叹,看来各大实验室已经攻克了RSI。
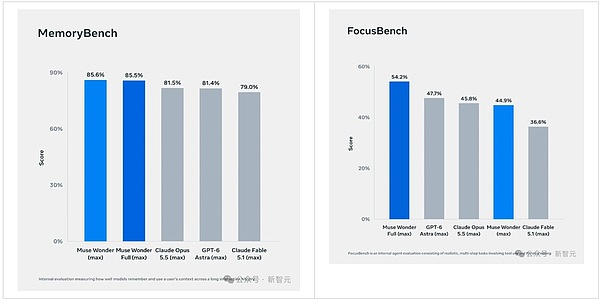
这次升级所有能力,划重点——
编程杀进第一梯队:Muse Code搭载Full,在AA编程Agent榜追平Claude Sonnet;两款Wonder在长任务测试中都超过Opus和Astra。
跨对话记住你,长任务接着干:Active Memory保留你的重要信息;Active Focus让模型遇到障碍时换办法、出错后检查,收到新要求再调整计划。
专业工作也追上来了:14项测试涵盖法律、金融、记忆和持续执行等能力,Full有8项超过Opus 5.5,11项超过GPT-6 Astra。
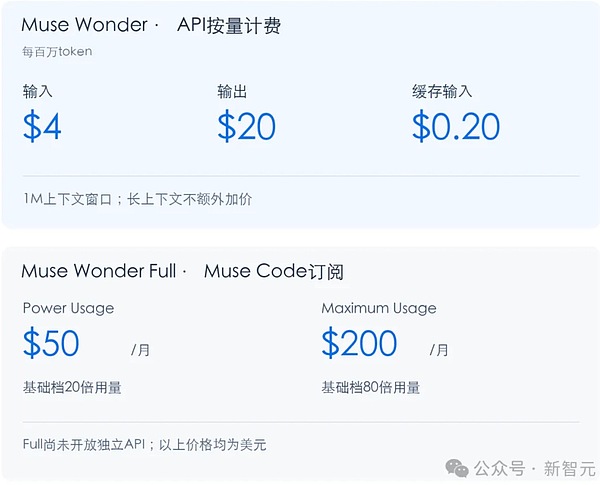
价格:普通版API每百万token输入4美元、输出20美元;Full通过Muse Code订阅开放,每月50或200美元。
六周猛涨8分,十项测试全赢前代!
按照Artificial Analysis的统计,Muse Spark 1.3和新模型的发布只隔了六周。
智能指数从48分冲到56分,涨了整整8分!
十项测试,全部超过Spark 1.3;六项冲进前三,两项拿到第一!
在科学推理CritPt和专业文档GDP.pdf中,Full都拿到33%,冲到AA当次榜单第一!考专业知识工作的GDPval-AA v2.1,Full拿到1857 Elo,排到第二。
另外三项第三,分别是知识工作AA-Briefcase、业务流程自动化AutomationBench-AA和科学编程SciCode。
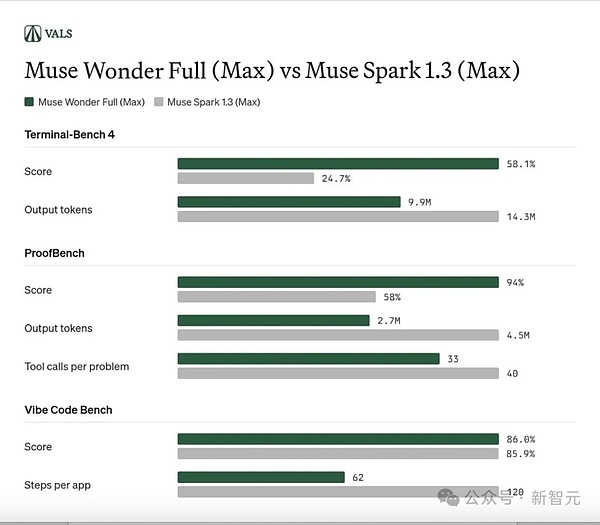
Terminal-Bench 4.0要求AI自己读文件、敲命令、处理报错。Spark只能完成33%的任务,Full已经做到57%,一口气提高24个百分点!
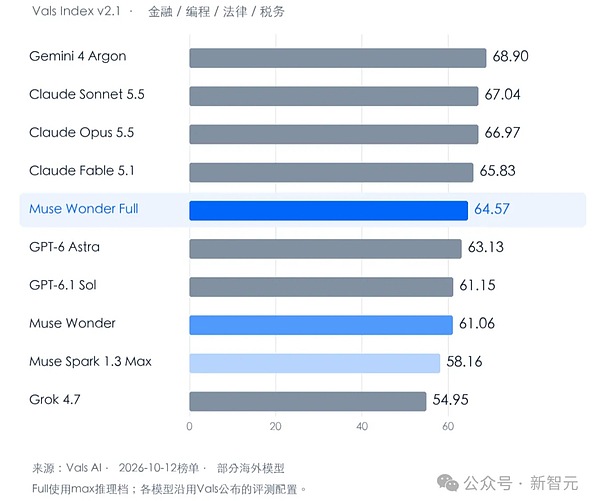
另一家评测机构Vals也公布了新成绩。
在覆盖金融、编程、法律和税务工作的Vals Index综合榜中,Wonder Full以64.57分冲到第五,超过榜上所有OpenAI模型!
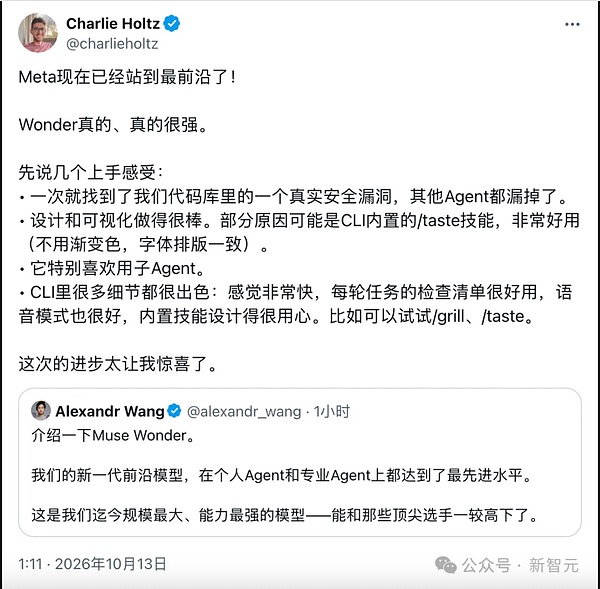
跑分之外,Conductor开发者Charlie Holtz已经把Wonder用进自己的代码库。
没想到,Muse一次就找到了一个真实安全漏洞,而其他Agent此前都漏掉了。
甚至,他还盛赞其设计和可视化效果、CLI的速度与语音模式,直言「Meta现在已经站到最前沿了」!
在另一场测试中,开发者Yair做了同题对比,让Wonder和Opus 5.5同出第一人称3D游戏。
Claude Code搭载Opus 5.5花了11分40秒,Muse Code搭载普通版Wonder只用3分42秒,连四分钟都没到!
长任务反超Opus,编程全面暴击Astra
在考核长程任务的基准SWE-Marathon上,Full拿到57.5%,Opus 5.5为46.3%,Astra为42.5%。
领先幅度分别达到11.2和15个百分点!
甚至不用上Full,普通版Wonder拿到53.1%,同样超过这两款旗舰。
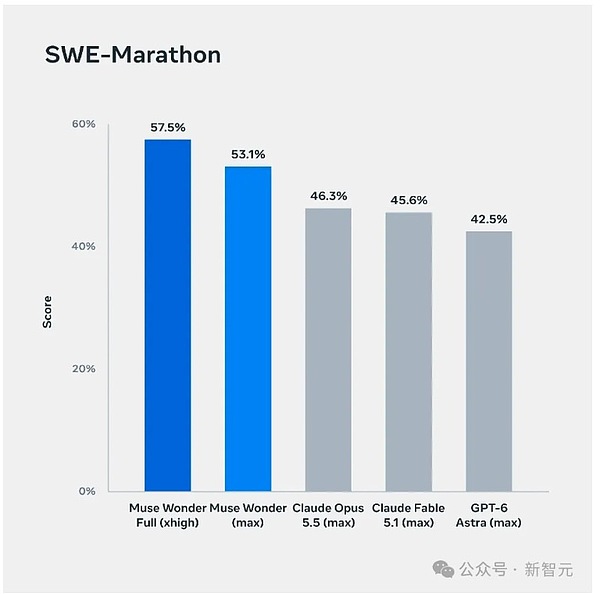
SWE-Marathon要求AI持续完成软件项目:读需求、改多个文件、跑测试,出错后还要自己找原因、接着改
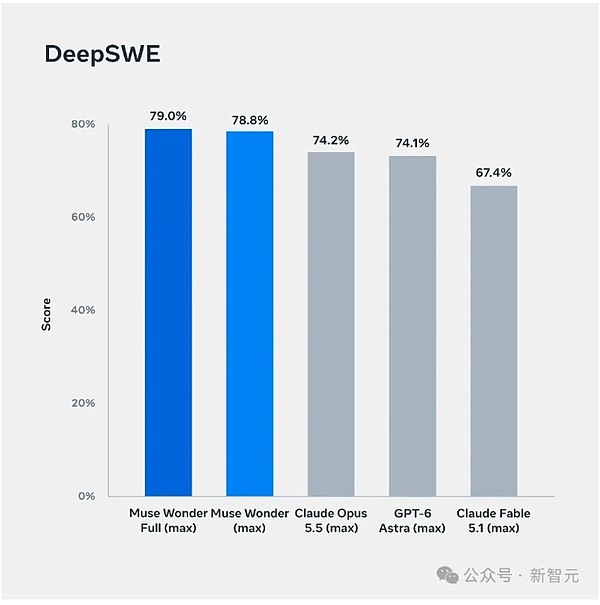
DeepSWE v1.1包含113项任务,涉及91个代码仓库、五种编程语言。
Meta汇总的成绩中,Full拿到79.0%,Wonder为78.8%,Opus和Astra分别为74.2%、74.1%。
再看AA的编程Agent榜(Coding Agents Index),Muse Code搭载Full拿到68分,追平Claude Code搭载Sonnet的成绩,超过搭载Opus的66分。
上一代Muse Code搭配Spark 1.3只有54分。换上Full,直接涨了14分!搭载普通版Wonder也有63分。
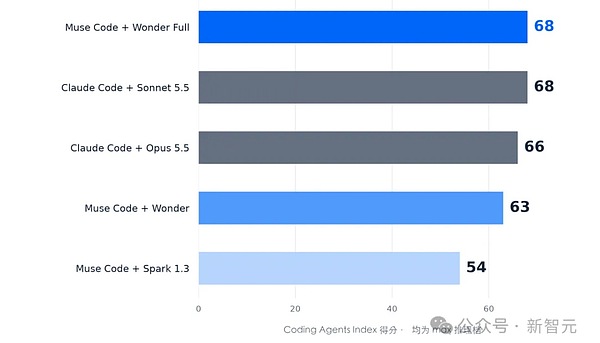
Artificial Analysis编程Agent测试,Muse Code与Claude Code的部分成绩
从零编程的ProgramBench中,Full拿到59.0,高于Astra的52.5,Opus为70.5。
终端编程成绩,Full为57.1,Astra和Opus分别是59.1、59.6。
此外,更大规模的漏洞测试也有了结果。
VulnPR-100的维护者给Wonder 1.0安排了100个含已知漏洞的代码变更,每个限时一小时。
它找出了46个,与GPT-6 Astra打平。整轮花费284.88美元,平均每个漏洞6.19美元。
数学多做对36题,token少了四成
在Vals AI的ProofBench中,Full做对94道数学证明题,比前代多36道;同榜Opus为100道、Astra为99道。
题做得更多,输出token反而从450万降到270万,少了四成!做应用时,得分维持在86%左右,平均步骤从120步减到62步。
14项有8项超过Opus,法律得分达到3.1倍
法律任务Harvey LAB-AA中,Full拿到13.1分,Opus为4.2分,前者达到后者的3.1倍!金融任务也拿到59.1分,超过Opus的58.6和Astra的53.5。
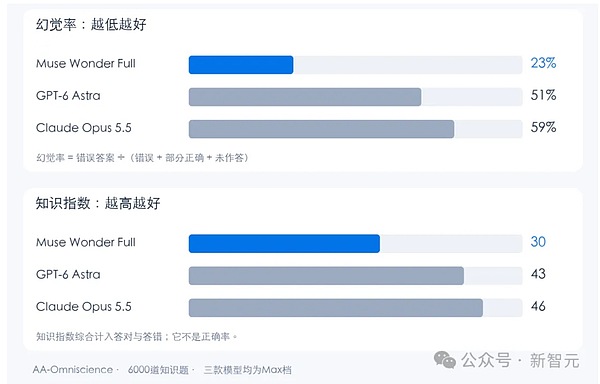
做专业工作,还得少编答案。AA的6000道知识题中,Full的幻觉率为23%,Astra为51%,Opus为59%;这里统计的是没答对的题里,仍然给出错误答案的比例。
Full更少硬答,但知识指数仍是30,低于Astra的43和Opus的46。
吉瓦级训练:普罗米修斯走出的「终极怪兽」
Muse Wonder之所以强的可怕,正是因为其背后动用了吉瓦级超算。
14个月前,Meta悄然启动了对其整个AI基础设施与研发范式的彻底重构。
这次Muse Wonder的诞生之地,正是业界传闻已久的吉瓦级Prometheus(普罗米修斯)超级数据中心。
Meta在这里继续扩大预训练和强化学习:预训练先建立广泛的基础能力,强化学习再根据任务反馈调整模型的行为。
更惊人的是其基础能力规格:
100万Token超大推理上下文:无论是一整套大型代码库、数百页的复杂并购合同,还是几个小时的音视频记录,统统能一口吞下;
原生全模态输入支持:打通文本、高分辨率图像、超长视频与连续音频;
Big Model Smell的质变:Meta在博客中特别回应了AI圈对模型「泛化能力」的质疑。
为了让模型能把复杂项目做完,Meta在训练中加入大量类型不同、耗时更长的任务。拿编程来说,模型要记住需求、修改多个文件,再经历一轮轮测试和返工,持续把项目往前推。
更强的基础模型,还要把学会的能力用到新问题上。
Meta逐档增加推理时的计算量,两代模型在陌生任务上的成绩都跟着提高。当它们在后训练重点覆盖的任务上得分相近时,Full在没有重点覆盖的任务上仍然更好。
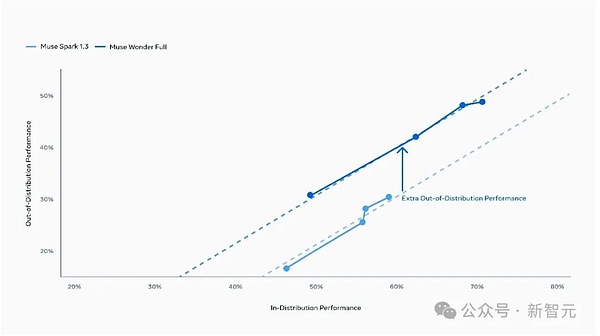
横轴为后训练重点覆盖的任务,纵轴为没有重点覆盖的任务
重建14个月,小扎终于打回来了!
现在,普通版Wonder已经在Meta Model API和Muse Code上线。
API按用量收费:每百万token输入4美元、输出20美元,缓存输入0.20美元。上下文窗口达到100万token,长上下文不额外加价。
Full目前只在Muse Code订阅中开放:Power Usage为50美元/月,Maximum Usage为200美元/月,分别提供基础档20倍、80倍的用量,暂未开放独立API。
个人助手Muse也将接入Wonder,按官方计划先向订阅者推出。
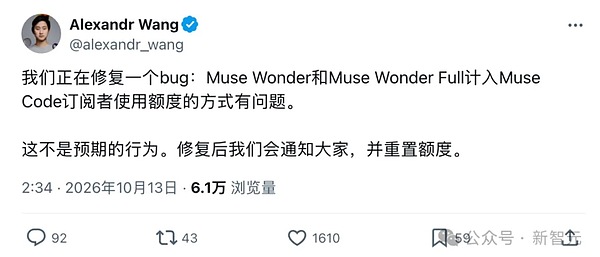
虽然首批用户遇到了额度异常,但Alexandr Wang表示,团队正在修复,并承诺修好后重置额度
这下,Claude Code和Codex的底盘,Meta也来抢了!
 0

声明:本文由入驻金色财经的作者撰写,观点仅代表作者本人,绝不代表金色财经赞同其观点或证实其描述。
提示:投资有风险,入市须谨慎。本资讯不作为投资理财建议。

24小时热文
 徐明星炮轰 CZ:“1011 暴跌”的账算清了吗?
Conflux树图区块链
 长鑫科技:吓坏了美韩存储巨头
凤凰网财经
 加密货币需要新规则而非又一个赌场
金色精选
 从一份 CPI 看懂美股板块轮动的底层逻辑
RockFlowUniverse
 金色Web3.0日报 | Solana定档Alpenglow升级
金色财经 善欧巴
 Bitwise:条条大路通BTC
金色财经
 银行股为何突然结构性大涨?
财经五月花
 Claude彻底解禁第三方应用
新智元
 OpenAI办公室惊现“窃听风云” 自家AI化身柯南
Odaily星球日报
 任何人都能授权?MakerDaoBot 因此损失 200 枚 ETH
BlockSec
- 寻求报道
- 金色财经APPiOS & Android
- 加入社群
Telegram - 意见反馈
- 返回顶部
- 返回底部