

 Android & iPhone
DeepSeek 为什么敢卖这么便宜?它把答案开源了
AI范儿
刚刚
DeepSeek 今天下午又开源了。说实话,看到的时候我挺意外。
这次不是模型,是它内部的推理框架 DeepInfer。线上那个 V4.1 Flash,就是靠它跑起来的。
一起放出来的,还有一个叫 deepseek-recipe 的编解码组件。
模型、算子库、编译工具,之前都开过了。现在连怎么把模型便宜地跑给海量用户,也一起交了出来。
我真服。推理成本是一家模型公司吃饭的家伙,DeepSeek 直接给了。
我一直在用 DeepSeek 的 API,写代码、跑 Agent 都用它。
在我看来,DeepSeek V4.1 Flash 是目前性价比最高的模型,而且非常耐用。充 100 块钱,能用很久。
当然,主要还是能力强。人狠话不多,直接就把活干了。
以前只知道它便宜,不知道为什么能这么便宜。这次 DeepSeek 发了一篇技术报告,仓库里还附了一份部署问答,把账摊开了。
我顺着钱的方向读了一遍。
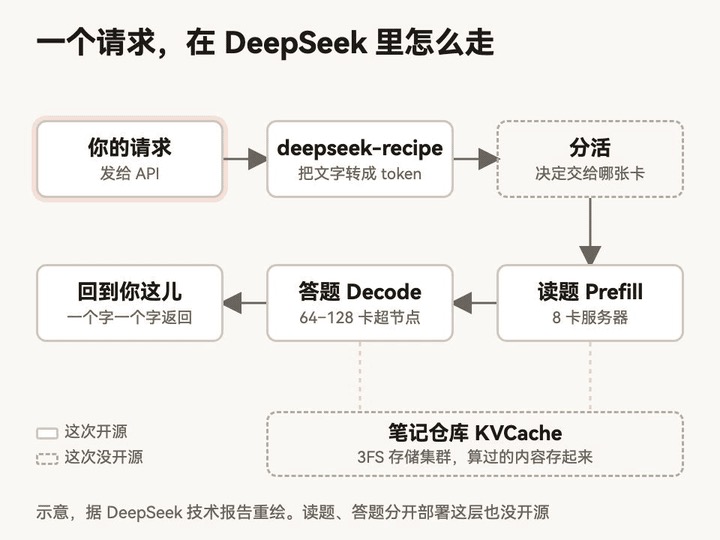
▲ 图:一个请求怎么走(示意)
AI 回你一句话,其实干了两件活
你给 DeepSeek 发一条消息,后台要分两步算。
先是读题,行话叫 Prefill。模型把你发来的东西从头读一遍,系统提示、聊天记录、贴进来的代码,一个不落。
读的时候,每个 token 在每一层都会留下一份中间结果,叫 KVCache。你可以把它想成读题时记在草稿纸上的笔记。
再是答题,行话叫 Decode。模型开始一个字一个字往外写,每写一个字,都要回头翻一遍前面所有的笔记。
这两步对机器的要求完全不同。读题一次要吞下几万个 token,拼的是算力。答题每次只写一个 token,大部分时间花在从显存里搬数据上。
所以 DeepSeek 把两步拆开,放在不同的机器上。读题用常见的 8 卡服务器,答题用 64 到 128 卡的超节点。两边的卡数,实际差不多是 1:1。
拆开以后,两边可以各自按自己的脾气调。DeepSeek 的部署问答里说,最小 1 组读题加 1 组答题就能跑,但想跑得划算,起步是 64 卡加 64 卡。
这也说明,这套东西不是给个人玩的,是给公司搭机房用的。
算过的,就别再算了
省钱最大的一笔,在缓存上。
写代码、跑 Agent 的人应该有体会。每调用一次工具,客户端都会把整段历史重新发一遍:系统提示、工具说明、前面每一轮的对话和结果。
一轮比一轮长,但前面那一大截,其实上一轮都读过了。
DeepSeek 的办法很直接:把读过的草稿纸存起来。下一轮请求进来,开头一样的部分直接拿旧笔记,只读新加的那一点。
注意,得是从第一个字开始就一模一样才算。中间某一段重复了,不行。
缓存这件事我是有感的。
技术报告里的线上数据是:平均每个请求带着 77K token 的输入,其中 96% 命中缓存。
这个数字落到价格上,差别非常大。DeepSeek 的价目表上,V4.1 Flash 在空闲时段,命中缓存的输入每百万 token 收 0.02 元,没命中的收 1 元,差了 50 倍。
我按这个价格算了一笔。一个 77K token 的请求,如果一点缓存都没有,光输入就要 7.7 分钱。
按 96% 的命中率算,只要不到半分钱,便宜了十几倍。高峰时段价格翻倍,但这个比例不变。
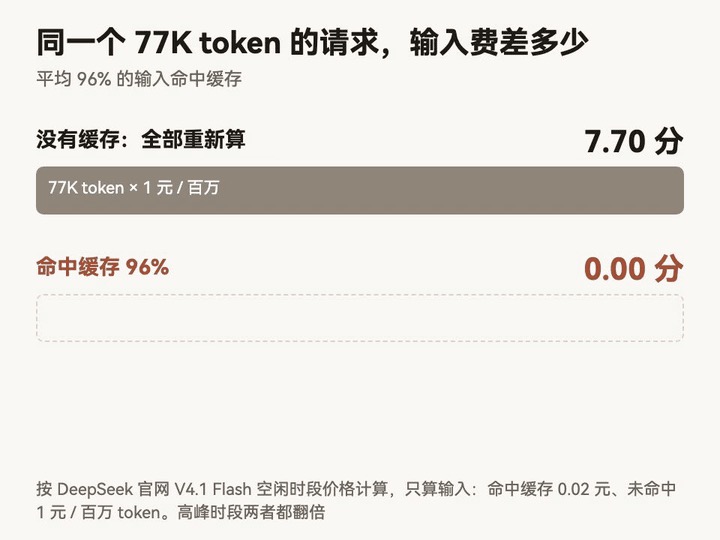
▲ 图:同一个请求,有没有缓存
对机器来说也是一样。同一张卡读题,不算缓存,每秒能处理 6 万个 token;算上命中缓存的部分,每秒是 150 万个,差了 25 倍。
同一张卡读题,每秒处理多少 token6 万 不算缓存150 万 算上命中缓存差 25 倍 数据:DeepSeek 技术报告,线上实测每卡吞吐
存得住,才命中得了
DeepSeek 给自己定的目标,是缓存至少留 72 小时。实际做得更久:部署问答里写,Agent 流量的缓存留 3 天,聊天流量留 7 天。
聊天为什么留得更久?因为有少数聊天的缓存,会被反复读很多次,一旦丢了,整体命中率掉得厉害。
DeepSeek 算过,聊天流量要是也只留 3 天,命中率会掉 0.5% 到 1%。
为了存下这么多笔记,DeepSeek 单独搭了一个存储集群,用的是它之前开源的 3FS 文件系统,大约 100 PiB 的固态硬盘。
笔记不放在算题的机器上,有两个好处。
一是谁都能拿。任何一台读题的机器,都能读到任何一段缓存,分请求的时候,不用非把你塞回上次那台机器。
二是不怕坏。DeepSeek 说,算题机器的故障率比存储机器高一个数量级以上。笔记放在存储集群里,算题的机器挂了,笔记还在。
存储集群自己也防着坏。数据拆成 10 份,再加 2 份校验,同时坏 2 台也能恢复。读的时候同时向 11 台机器要数据,先回来 10 份就够用。
读缓存也不能拖慢你看到第一个字的时间。线上平均输入 77K token,首字延迟平均 400 毫秒,最慢的那 1% 也在 1 秒左右。
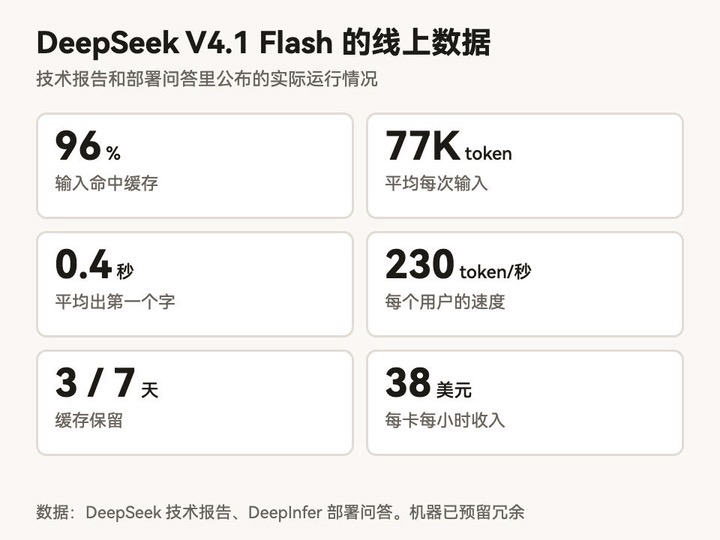
▲ 图:DeepSeek 线上数据
短期记忆丢了,只补最后一小段
V4.1 Flash 里,有一部分层用的是滑动窗口注意力,简称 SWA。它只看离自己最近的 128 个 token,像一份短期记忆。
这份短期记忆,DeepSeek 不往硬盘里存,只放在算它的那台机器的内存里,大约 3 分钟就清掉。
因为它只在一场对话进行中的那几分钟有用,命中率仍然在 98% 以上。
上一代 V4 不是这么做的。V4 把短期记忆也写进硬盘,丢了就逐层精确重算。结果这部分占了硬盘缓存将近一半的容量,换来的命中收益却不成比例。
用存好几天的硬盘,去装只活几分钟的数据,DeepSeek 自己也觉得不划算。
V4.1 改成了 SWA Bounded Replay。短期记忆丢了,就只重算最后 128 个 token,而且算的时候只在这 128 个 token 里面看。
得到的是一份近似的短期记忆,但重算的成本固定下来了,和对话多长、模型多少层都没关系。
同样的思路,还用在了模型另外 20 层上。这 20 层每次读题都要重建短期记忆,原来要算最后 2560 个 token,现在只算 128 个。
整个读题阶段的计算量,因此少了将近一半。
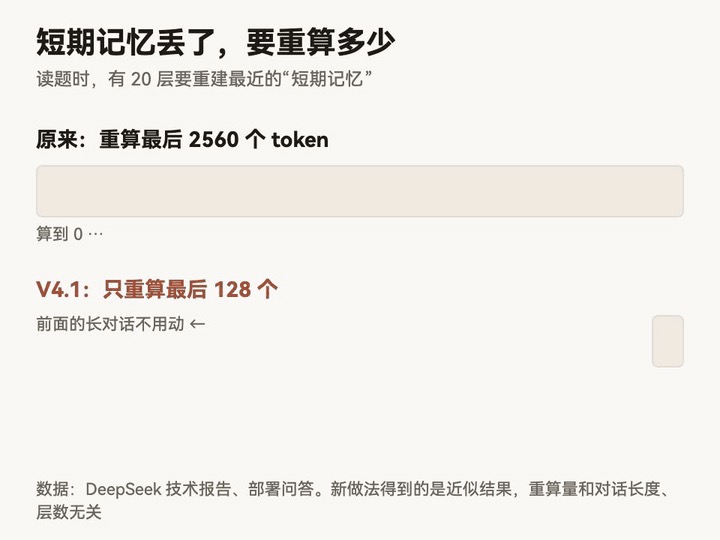
▲ 图:从 2560 个到 128 个
一次多写几个字
到了答题阶段,模型每算一步,只能写出一个 token。想快,就得想办法一步多写几个。
DeepSeek 用的是投机解码。先让一个很轻的草稿模块连着猜 5 个 token,再让大模型一次把这 5 个都检查一遍。
猜对的直接用,在第一个猜错的地方,大模型给出正确答案。这样算一步,就能拿到不止一个 token。
DeepSeek 自己的版本叫 DSpark,又多做了一步:先估计每个猜测有多大把握。把握小的,干脆不检查,把检查的算力让给别的请求。
部署问答里给了数字:每一步要检查的 token 少了大约三成,最后被采用的长度基本没变,线上吞吐多了 6% 左右。
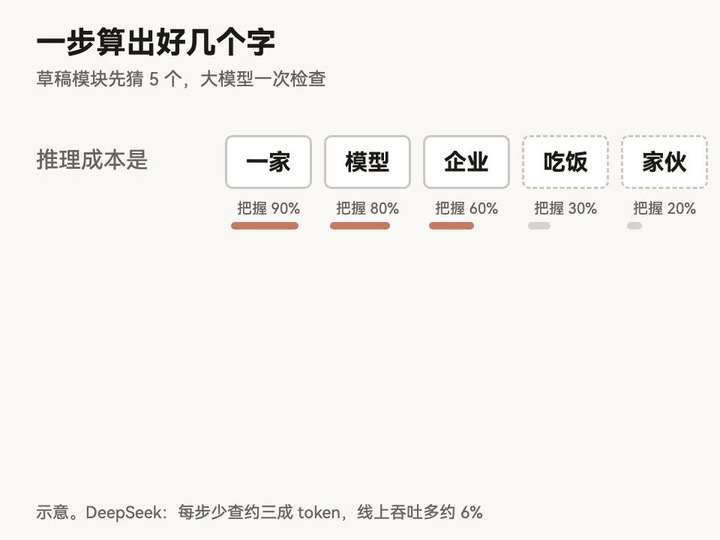
▲ 图:先猜,再一次检查
还有一处小浪费,也被抠掉了。每两步之间,CPU 要安排下一步算谁、处理上一步的结果,这段时间 GPU 原本在干等。
DeepInfer 让两边错开干:GPU 算第 N 步的时候,CPU 已经在排第 N+1 步了。
最后的线上结果是,答题阶段每张卡每秒写出 1.4 万个 token,每个用户每秒能看到 230 个 token,写代码的场景是 300 个。
每张卡都别闲着
卡是最贵的东西,空转一秒都是钱。
V4.1 Flash 是 MoE 模型,里面有 384 个路由专家,每个 token 只会用到其中几个。
答题阶段,DeepSeek 把这些专家摊到 64 张卡上,每张卡放 6 个,再多放 1 个热门专家的副本,一共 7 个。
每张卡上放的专家越少,每一步要从显存里搬的数据就越少,同样多的卡,就能同时接更多请求。
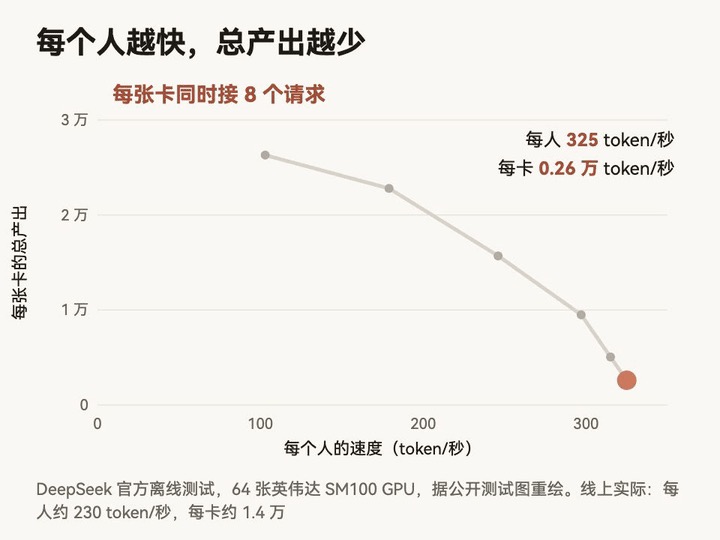
▲ 图:人越多,总量越高,每人越慢(官方离线测试)
哪个专家热门,是会变的。DeepSeek 每 1000 步统计一次各专家忙不忙,每 10000 步重新分一次副本。线上实测,最忙的那张卡只比平均水平忙 9%。
请求也要分得匀。读题这边,按输入长度分成 4 档,16K 以下、16K 到 64K、64K 到 256K、256K 以上,每档分几台机器,按上一轮的需求随时调。
答题这边,同时看两件事:每张卡上有几个请求,这些请求的笔记有多长。短请求给请求少、笔记长的卡,长请求给笔记短的卡。
这么调下来,整体能达到理想状态的八成左右。
机器数量也跟着流量走。读题看没命中缓存的 token 有多少,答题看手上在跑的请求有多少,多了加机器,少了撤机器。
但 DeepSeek 永远多留一点余量,配额用到八成以上,就不许再缩。
还有一个麻烦。答题时 64 张卡是一个整体,坏一张,整组都得停。
重启要几分钟,DeepSeek 的办法是把请求转给别的组接着算,再用剩下的好卡重新组一组,不等那张坏卡。
一张卡一小时 38 美元
把上面这些加在一起,就是 DeepSeek 报出来的那个数。
平均每张卡每小时收入38 美元按谷价算,是收入不是利润猜一猜一张卡一小时,能收多少钱?想好了就点一下
部署问答里写,目前单个集群每天处理 155 万亿个 token,平均每张卡每小时的收入是 38 美元,按谷价算。
一家公司把每张卡能赚多少钱都写出来,我很少见。当然这是收入,不是利润,也是 DeepSeek 自己报的数。
昇腾也能跑,但没全给
DeepInfer 同时支持英伟达 SM100 系列和华为昇腾 950。开源协议是 Apache 2.0,deepseek-recipe 是 MIT。
deepseek-recipe 干的是收发的活。现在主流的 API 格式有好几种,它把这些请求统一转成模型认识的 token,再把模型写出来的 token 转回去,处理逻辑和 DeepSeek 官方 API 完全对齐。
别人自己部署 DeepSeek 的模型,接口表现能和官方一样。
它还顺手堵了一个口子。DeepSeek 的模型用一些特殊标记来区分谁在说话、思考什么时候结束、什么时候调用工具。
要是有人在输入里手动写上这种标记,deepseek-recipe 只把它当成普通文字,模型不会被骗。
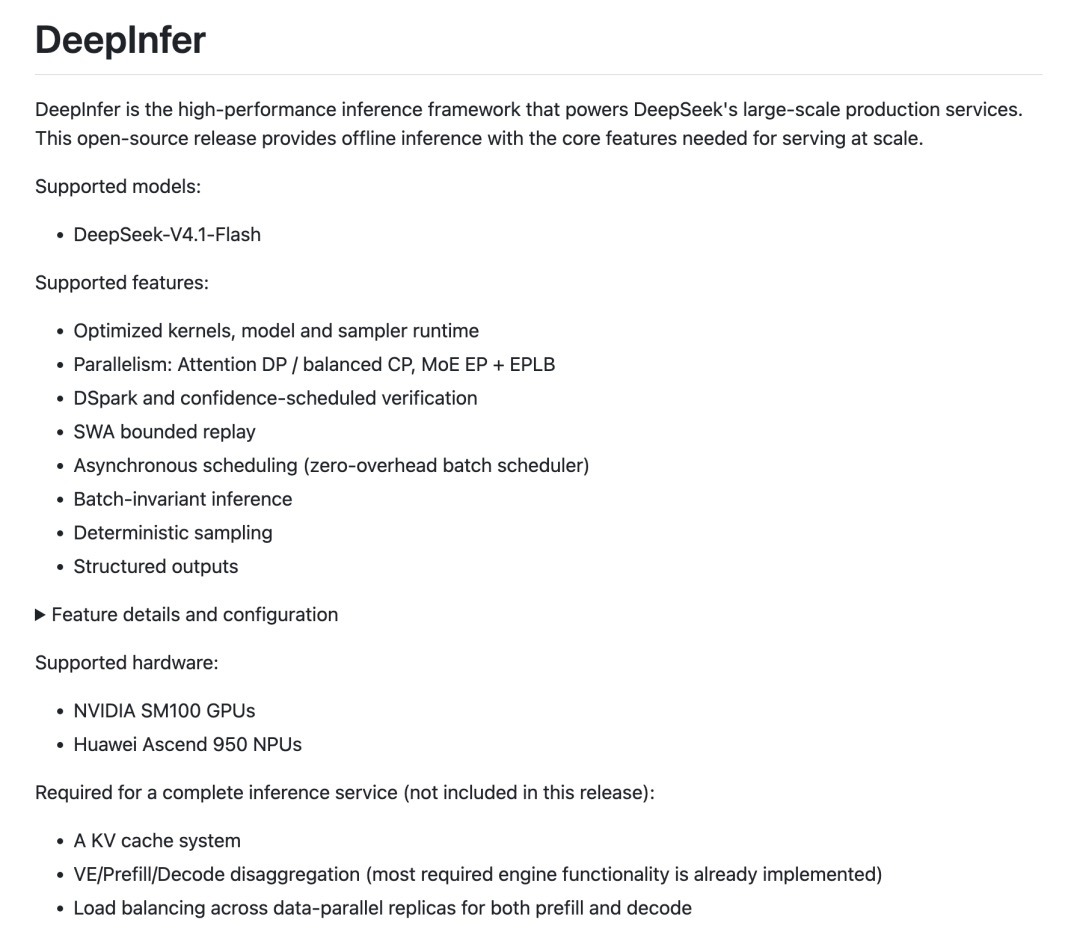
▲ 图:DeepInfer 的 GitHub 说明
公平地说,这次不算全家桶。
KVCache 存储系统、读题和答题的分离部署、多副本之间的负载均衡,这三块都没放出来。DeepSeek 的解释是,它们和内部基础设施绑得太深。
也就是说,拿到 DeepInfer,你能做离线推理。但要搭一个和 DeepSeek 官方一样的完整线上服务,上面讲的缓存和分活这些,还得自己补。
DeepSeek 也大方承认,DeepInfer 最早主要是在 vLLM 上搭起来的,还借鉴了 SGLang 和 TensorRT-LLM。
网友怎么看
DeepSeek 公告下面的评论,几乎一边倒。
我挑了四条,往左滑着看。学霸那个比喻最戳我。
评论 1 · 共 4 条
有人说
这才是真正的 OpenAI。
评论 2 · 共 4 条
村里的学霸
村里有个学霸,人特别好,不光免费让你抄作业,还免费给你讲课。
评论 3 · 共 4 条
路口的馆子
路口有家馆子,好吃又便宜,还把配方挂在门口,想自己做的拿回家照着弄,老板只希望人人都能吃上好饭。
评论 4 · 共 4 条
有人翻出 DeepSeek 以前那句话
不诱于誉,不恐于诽,率道而行,端然正己。
这两个比喻挺准。模型开源是让你抄作业,推理框架开源是连怎么做出来都教你了。
以后会有更多 Token 工厂
DeepSeek 接下来还会开源什么、能走多远,我很好奇。
但我觉得更重要的是另一件事:把模型变成 token 卖出去的那套本事,正在变成公开的东西。
以后能自己搭 token 工厂的公司会越来越多。云厂商会拿去省成本,大公司会自己部署,别的模型公司也会跟着拼成本,这几种情况我觉得都会有。token 的价格也会越来越低。
你觉得,下一个把推理框架开出来的,会是谁?
参考资料
01|DeepSeek:DeepSeek 开源推理框架:走向真正普惠的未来(2026-10-20)https://mp.weixin.qq.com/s/5MEu2eeqNfBWXlkCKTd6sg
02|DeepSeek:DeepSeek V4.1 Flash 大规模推理部署实践(知乎)https://zhuanlan.zhihu.com/p/2095560295930508953
03|DeepSeek:DeepSeek V4.1 Flash 推理部署 Q&A(DeepInfer 仓库)https://github.com/deepseek-ai/DeepInfer/tree/main/doc
04|GitHub:deepseek-ai/DeepInferhttps://github.com/deepseek-ai/DeepInfer
05|DeepSeek:模型 & 价格https://api-docs.deepseek.com/zh-cn/quick_start/pricing
 0

声明:本文由入驻金色财经的作者撰写,观点仅代表作者本人,绝不代表金色财经赞同其观点或证实其描述。
提示:投资有风险,入市须谨慎。本资讯不作为投资理财建议。

24小时热文
 HYPE第三季要发8亿美元?
金色精选
 如何让“数据契约”成为智能体数据治理操作系统?
数字新财报
 企业回购重启:华尔街最大买家即将按下买入键?
华尔街见闻
- 寻求报道
- 金色财经APPiOS & Android
- 加入社群
Telegram - 意见反馈
- 返回顶部
- 返回底部